












LLMとは?仕組み・生成AIとの違い・ローカルで使う方法を初心者向けに解説
LLM(Large Language Model/大規模言語モデル)とは、大量のデータから言語のパターンを学習し、入力された文脈に基づいて次のトークンを予測するAIモデルです。 質問への回答、文章作成、要約、翻訳、情報抽出、コード生成などに利用されています。
ChatGPT、Claude、GeminiなどのAIサービスにもLLMが使われています。ただし、AIサービスとLLMは同じものではありません。AIサービスは、LLMに検索、ファイル処理、画像認識、音声、外部ツールなどを組み合わせて提供されることがあります。
本記事では、LLMの意味と仕組み、生成AIとの違い、できることと苦手なこと、クラウド型とローカル型の選び方を初心者向けに解説します。

LLMとは?
LLMは、人間が使う言語を処理・生成するための機械学習モデルです。「大規模」と呼ばれる理由は、モデルを構成するパラメータ、学習データ、学習に使う計算量などが大きいことにあります。
LLMは、入力された文章をそのまま理解しているわけではありません。文章をトークンと呼ばれる単位へ分割し、トークン同士の関係と、それまでの文脈を数値として処理します。その結果を基に、次に続く可能性のあるトークンを計算して回答を生成します。
LLMの「B」は何を意味する?
モデル名にある7B、14B、32B、70Bなどの「B」は、Billion(10億)を意味します。7Bモデルなら約70億、70Bモデルなら約700億のパラメータを持つモデルという意味です。
一般的にはパラメータ数が増えるほど、モデルを保存・実行するために大きなメモリが必要になります。ただし、パラメータ数が多ければ、すべての用途で必ず高品質になるわけではありません。学習データ、モデル構造、追加学習、量子化、質問内容との相性も影響します。
モデル規模別のメモリ容量は、7B・14B・32B・70Bモデルに必要なメモリで詳しく解説しています。
AI・生成AI・LLMの違い
AI、生成AI、LLMは、対象とする範囲が異なります。
| 用語 | 意味 | 代表的な用途 |
| AI(人工知能) | 判断、予測、認識、生成などを行う技術全体 | 画像認識、需要予測、音声認識、異常検知 |
| 生成AI | 文章、画像、音声、動画、コードなどを生成するAI | 文章作成、画像生成、動画生成、作曲 |
| LLM | 言語の処理と生成を中心に設計された大規模モデル | 質問回答、要約、翻訳、コード生成 |
LLMはAIの一種であり、多くの場合は生成AIにも含まれます。一方、画像生成モデルや音声生成モデルは生成AIですが、必ずしもLLMではありません。
現在は、文章だけでなく画像、音声、動画などを扱えるマルチモーダルモデルも増えています。そのため、サービス全体を説明するときは「LLM」より「生成AI」や「AIモデル」のほうが適切な場合があります。
代表的なLLMとAIサービス
一般ユーザーが利用するAIサービスと、その背後にあるモデル系列の代表例は次のとおりです。
| AIサービス・提供元 | 主なモデル系列 | 主な提供形態 |
| ChatGPT/OpenAI | GPTシリーズ | クラウドサービス、API |
| Claude/Anthropic | Claudeシリーズ | クラウドサービス、API |
| Gemini/Google | Geminiシリーズ | クラウドサービス、API |
| Meta | Llamaシリーズ | 公開ウェイトモデル、クラウド経由の提供 |
| Alibaba Cloud | Qwenシリーズ | 公開ウェイトモデル、クラウド経由の提供 |
| Gemmaシリーズ | 公開ウェイトモデル | |
| Mistral AI | Mistralシリーズ | 公開ウェイトモデル、クラウドサービス |
| Microsoft | Phiシリーズ | 小型モデル、公開ウェイトモデル |
モデルのバージョンと提供状況は頻繁に更新されます。また、「公開ウェイト」と「オープンソース」は同じ意味ではありません。利用、改変、再配布、商用利用の条件はモデルごとのライセンスで確認してください。
LLMが文章を生成する仕組み
LLMの処理は、大きく「トークン化」「学習」「調整」「推論」に分けて考えると理解しやすくなります。
1. 文章をトークンへ分割する
LLMは、入力された文章をトークンと呼ばれる単位へ分割します。トークンは必ずしも1単語ではありません。日本語では、1つの単語が複数のトークンへ分かれたり、文字や単語の一部が1トークンとして扱われたりします。
同じ文章でも、モデルが使用するトークナイザーによってトークン数が異なる場合があります。利用料金、入力できる文章量、コンテキスト長を考えるときは、文字数ではなくトークン数が基準になります。
2. Transformerで文脈を処理する
現在の多くのLLMは、Transformerと呼ばれるニューラルネットワークの仕組みを基礎としています。TransformerはAttentionという機構を使い、入力文の中でどのトークン同士が強く関係しているかを計算します。
たとえば、長い文章に複数の人物名が登場するとき、代名詞がどの人物を指しているか、質問と関連する部分がどこにあるかを判断するために文脈上の関係を利用します。
ただし、コンテキストへ文章を入れれば、必ず正しく理解できるわけではありません。入力が長い、曖昧、矛盾している場合は、回答の精度が低下することがあります。
3. 大量のデータで事前学習する
事前学習では、文章、コードなどのデータから言語のパターンを学習します。学習データの種類、規模、品質、利用許諾はモデルによって異なります。
この段階でモデルは、文法、文章構造、単語同士の関係、さまざまな分野に現れるパターンをパラメータへ反映します。ただし、学習内容を検索可能なデータベースとしてそのまま保存しているわけではありません。
4. 指示に従うよう調整する
事前学習したモデルは、そのままではユーザーの指示に適切に答えられるとは限りません。そこで、指示と回答の例を使った追加学習、人間またはAIによる評価、安全性の調整などを行います。
こうした調整によって、質問への回答、要約、会話、コード作成など、利用者の意図に沿った出力を生成しやすくなります。
5. 次のトークンを予測して回答する
利用者がプロンプトを入力すると、LLMはそれまでの文脈を基に、次に続くトークンの確率分布を計算します。選ばれたトークンを文脈へ加え、さらに次のトークンを計算する処理を繰り返して文章を生成します。
常に最も確率が高い候補だけを選ぶとは限りません。温度などの生成設定によって、複数の候補からどの程度多様な出力を選ぶかが変わります。そのため、同じ質問でも回答が異なる場合があります。
LLMでできること
LLMは、言語やコードを扱う幅広い作業に利用できます。
- 質問への回答と説明
- 長い文章や会議記録の要約
- 翻訳と文章の言い換え
- メール、企画書、記事の下書き
- 情報の抽出と分類
- プログラムコードの作成と説明
- 社内文書を参照するRAG
- 外部ツールを利用するAIエージェント
- 画像を扱えるモデルによる画像内容の説明
LLMの出力は、そのまま完成物として使うより、下書き、情報整理、確認項目の抽出などに使い、人が内容を検証する方法が安全です。
LLMが苦手なことと注意点
LLMは自然な文章を生成できますが、回答が自然であることと、内容が正しいことは同じではありません。
事実と異なる情報を生成することがある
LLMは、もっともらしい誤情報、存在しない出典、誤った数字を生成することがあります。これはハルシネーションと呼ばれます。
医療、法律、金融、契約、製品仕様など、正確性が重要な情報は、公式資料や専門家の確認が必要です。LLMが示したURLや引用元も、実際に存在するか確認してください。
最新情報を知らない場合がある
モデルには学習期間や知識の基準日があります。検索機能を備えたAIサービスでも、参照先が古い、取得できない、解釈を誤る可能性があります。
製品価格、在庫、法律、ソフトウェア対応、モデルの提供状況など、変化する情報は公式ページで確認してください。
計算や論理推論を誤ることがある
LLMは計算式や推論過程を説明できますが、計算を必ず正しく実行する保証はありません。正確な計算には、電卓、表計算ソフト、コード実行などの外部ツールを組み合わせます。
入力データの扱いを確認する必要がある
クラウド型AIへ機密情報や個人情報を入力する前に、利用規約、データ保持、学習への利用、管理者設定を確認してください。ローカルLLMでも、Web検索、クラウド同期、テレメトリー、外部APIを有効にすると通信が発生する場合があります。
クラウド型LLMとローカルLLMの違い
クラウド型LLMは、提供企業のサーバーで推論します。ローカルLLMは、自分のPCや社内サーバーへモデルを保存して推論します。
| 比較項目 | クラウド型LLM | ローカルLLM |
| 導入 | アカウント作成後すぐ使いやすい | モデル、推論ソフト、PC環境の準備が必要 |
| 処理場所 | 提供企業のサーバー | 自分のPCまたは管理するサーバー |
| PCスペック | ブラウザを使える一般的な端末でも利用可能 | モデルに合うRAM、VRAM、CPU・GPUが必要 |
| インターネット | 通常は必要 | 準備後にオフライン運用できる構成もある |
| データ管理 | 提供企業のポリシーと契約条件に依存 | ローカル処理なら管理範囲を限定しやすい |
| モデル更新 | 提供企業が実施 | 利用者がモデルとソフトを管理する |
| 費用 | 無料枠、月額料金、API従量課金など | PC、電気、保守、ストレージなどが必要 |
| カスタマイズ | サービスが許可する範囲 | モデル、量子化、設定、RAGを選びやすい |
クラウド型が向いている人
- PC設定に時間をかけず、すぐに使いたい
- 大規模モデルや最新機能を利用したい
- 使用頻度が低く、ハードウェアを購入したくない
- 提供企業の管理機能やサポートを重視する
ローカル型が向いている人
- 対応する処理を自分の管理する環境内で完結させたい
- オフライン環境で利用したい
- モデルや量子化、コンテキストを細かく選びたい
- ローカルAPI、RAG、AIエージェントを常時動かしたい
- 継続的なAPI利用量とPC保有コストを比較したい
クラウドとローカルは、どちらか一方に統一する必要はありません。一般的な質問はクラウド、機密文書の検索はローカルというように、用途で使い分ける方法もあります。
ローカルLLMを使うために必要なもの
ローカルLLMを動かすには、PC、モデルファイル、推論ソフトが必要です。
| 必要なもの | 役割 | 確認項目 |
| PC | モデルを保存し、推論を実行する | RAM、VRAM、GPU対応、SSD、冷却 |
| モデル | 言語処理と文章生成を行う | パラメータ数、量子化、ライセンス |
| 推論ソフト | モデルを読み込み、CPUやGPUで実行する | OS、GPU、モデル形式への対応 |
4bit量子化モデルを1つ使用する場合、システムメモリの目安は、7B~8Bで16~32GB、14Bで32~64GB、32Bで64~96GB、70Bで96~128GBです。実際の必要量は、モデル形式、コンテキスト長、KVキャッシュ、GPUへの割り当て、同時に使うアプリによって変わります。
CPU、GPU、NPU、RAM、VRAM、SSDを含む詳しい選び方は、ローカルLLMに必要なPCスペックをご覧ください。ローカルAI環境全体の選び方と導入手順は、ローカルAI・LLM向けミニPC完全ガイドで解説しています。
LLM・推論ソフト・AIエージェントの違い
LLM、Ollama、LM Studio、AIエージェントは、それぞれ役割が異なります。
| 種類 | 例 | 役割 |
| LLM | Llama、Qwen、Gemma、Mistral、Phi | 言語を処理して回答を生成するモデル |
| 推論ソフト | Ollama、LM Studio、llama.cpp | モデルを読み込み、CPUやGPUで実行する |
| RAGシステム | ベクトルDBと検索機能を組み合わせた構成 | 関連文書を検索し、LLMへ文脈として渡す |
| AIエージェント | OpenClawなど | LLMと外部ツールを組み合わせて複数手順を実行する |
LM Studioは、GUIからモデルの検索、ダウンロード、実行、ローカルAPIの提供を行える推論アプリです。Ollamaは、コマンド操作とローカルAPIを使ってモデルを管理・実行できます。llama.cppは、GGUFモデルをCPUや複数のGPUバックエンドで実行する基盤です。
AIエージェントはLLMそのものではありません。LLMへ指示を送り、ファイル操作、検索、ブラウザ、コード実行などのツールを組み合わせて目的を達成します。常時稼働する構成は、OpenClaw向けミニPCの必要スペックで確認できます。
ミニPCでもLLMを動かせる?
十分なメモリと対応する推論環境があれば、ミニPCでもローカルLLMを実行できます。ただし、「AI PC」や「NPU搭載」と書かれているだけでは、使いたいモデルを快適に動かせるとは限りません。
購入前に、次の項目を確認してください。
- 使用するモデルのパラメータ数と量子化
- RAMとGPUで利用できるメモリ容量
- 推論ソフトのGPU対応
- メモリの増設可否
- SSD容量と増設スロット
- 長時間運用時の冷却
- ローカルAPIに使うLANとセキュリティ
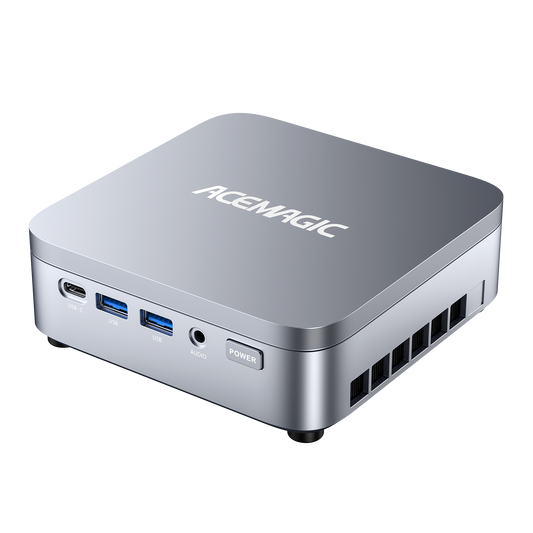
たとえばACEMAGIC F5AのDDR5構成は、AMD Ryzen AI 9 HX 470、Radeon 890M、32GB DDR5メモリ、1TB SSDを搭載し、最大128GBまでのメモリ増設に対応しています。7B~14Bから始め、用途に合わせてシステムメモリを増やしたい場合の候補です。
F5Aには増設可能なDDR5構成と、オンボードで増設できないLPDDR5X構成があります。購入時は構成を確認してください。また、システムメモリを増やすことと、専用GPUのVRAMを増やすことは同じではありません。製品名だけでなく、モデル、OS、推論ソフトとの組み合わせを確認する必要があります。
ほかの構成は、ACEMAGICのミニPC一覧から比較できます。
LLMを安全に利用するための確認事項
LLMを業務や学習に使う場合は、次の点を確認してください。
- 出力された事実、数字、引用元を確認する
- 個人情報、機密情報、認証情報を不用意に入力しない
- モデルとサービスの利用規約を確認する
- 著作権、ライセンス、社内ルールを確認する
- 重要な判断をLLMの回答だけで決めない
- ローカルAPIを認証なしでインターネットへ公開しない
- モデルと推論ソフトを信頼できる配布元から取得する
ローカルLLMはデータ管理の範囲を限定しやすい一方、設定、アップデート、アクセス制御は利用者側の責任になります。
まとめ
LLMは、大量のデータから言語のパターンを学習し、文脈に基づいて次のトークンを予測するAIモデルです。質問回答、要約、翻訳、文章作成、コード生成などに利用できます。
重要なポイントは次のとおりです。
- LLMはAIの一種で、主に言語を処理する
- 文章をトークンへ分割し、次のトークンを順番に生成する
- 自然な回答でも、事実が正しいとは限らない
- クラウド型は導入しやすく、ローカル型は環境を管理しやすい
- ローカルLLMには、モデルに合うRAM・VRAMと推論ソフトが必要
- 公開ウェイトモデルは、モデルごとのライセンス確認が必要
ローカル環境でLLMを始めたい場合は、最初に使用するモデル規模を決めてください。そのうえで、ローカルLLMに必要なPCスペックとモデル規模別の必要メモリを確認すると、過不足の少ない構成を選びやすくなります。
FAQ:LLMに関するよくある質問
LLMは何の略ですか?
LLMはLarge Language Modelの略で、日本語では大規模言語モデルと呼ばれます。大量のデータから言語のパターンを学習し、文章の処理と生成を行うAIモデルです。
AIとLLMの違いは何ですか?
AIは、認識、判断、予測、生成などを行う技術全体を指します。LLMはAIの一種で、主に文章、会話、コードなどの言語情報を扱います。
生成AIとLLMは同じですか?
同じではありません。LLMは文章やコードを生成する生成AIの一種です。生成AIには、画像、音声、音楽、動画を生成するモデルも含まれます。
LLMは文章を理解しているのですか?
LLMはトークン同士の関係と文脈を数値として処理し、人間が理解しているように見える回答を生成します。ただし、人間と同じ意識や理解を持っていると確認されたわけではありません。
LLMはインターネットを検索していますか?
LLM単体は、回答するたびに自動でインターネットを検索するわけではありません。検索機能を備えたAIサービスでは、外部情報を取得してLLMへ渡す仕組みが追加されています。
LLMの回答は信用できますか?
参考情報や下書きとして利用できますが、誤った事実や存在しない出典を生成することがあります。重要な内容は、公式資料や信頼できる一次情報で確認してください。
ローカルLLMは完全にオフラインで使えますか?
モデルと推論ソフトを事前にダウンロードし、外部APIやWeb検索を使わない構成なら、オフラインで推論できます。ただし、アップデート、モデル取得、クラウド同期などには通信が必要です。
ローカルLLMは無料ですか?
質問ごとのAPI料金がかからないモデルもありますが、PC購入費、電気代、ストレージ、保守費用が発生します。また、無料で取得できるモデルでも、商用利用や再配布に条件がある場合があります。
16GBメモリでローカルLLMを動かせますか?
小型の4bit量子化モデルなら動作する場合があります。Windowsやブラウザを同時に使い、7B~14Bを試す場合は32GBのほうが余裕を持ちやすくなります。
NPUがあればLLMは速くなりますか?
必ず速くなるわけではありません。推論ソフトとモデルがNPUに対応している必要があります。一般的なローカルLLMでは、GPU対応、RAM・VRAM容量、メモリ帯域も確認してください。